Kerasを用いた画像識別
前回、ポケモンのステータスからポケモンのタイプを判定するソフトを作成しました。
elsammit-beginnerblg.hatenablog.com
elsammit-beginnerblg.hatenablog.com
今回は画像の識別を行いたいと思います。
識別画像ですが、いらすとやの犬と猫を行います。
いらすとやの犬と猫はこんな感じですね。
今回はすでにいらすとやの犬と猫の画像が集まっていること前提で記載させていただきます。
自分は犬、猫ともに60枚程度用意いたしました。
■画像識別モデル
識別モデルですが、下記を参考(ほぼコピー)に作成いたしました。
画像認識で「綾鷹を選ばせる」AIを作る - Qiita
後でモデルについてはまとめて行いたいと思います。
今回利用するモデルはこんな感じと思っていただければ、と思います。
def CNN():
    model = models.Sequential()
    model.add(layers.Conv2D(32,(3,3),activation="relu",input_shape=(150,150,3)))
    model.add(layers.MaxPooling2D((2,2)))
    model.add(layers.Conv2D(64,(3,3),activation="relu"))
    model.add(layers.MaxPooling2D((2,2)))
    model.add(layers.Conv2D(128,(3,3),activation="relu"))
    model.add(layers.MaxPooling2D((2,2)))
    model.add(layers.Conv2D(128,(3,3),activation="relu"))
    model.add(layers.MaxPooling2D((2,2)))
    model.add(layers.Flatten())
    model.add(layers.Dense(512,activation="relu"))
    model.add(layers.Dense(2,activation="sigmoid"))

    model.summary()
return modelこちらのモデルをコンパイルしていきます。
コンパイルコードはこちら。
def Compile():
    model = CNN()
    model.compile(loss="binary_crossentropy",
              optimizer=optimizers.RMSprop(lr=1e-4),
              metrics=["acc"])
    return model
■学習データ準備
先ほどのモデルに学習させるために、画像データと犬・猫のフラグを関連づけや画像データ整備等を行っていきます。
まずは画像の読み出しと画像に対する犬、猫データを組み合わせてリストを作成していきます。
ソースはこんな感じです。
allFiles = []
def zyunbi():
    for imgpath in nekofiles:
        imgpath = "./neko/" + imgpath
        allFiles.append((0,imgpath))
    for imgpath in inufiles:
        imgpath = "./inu/" + imgpath
        allFiles.append((1,imgpath))
    random.shuffle(allFiles)
    th = math.floor(len(allFiles) * 0.8)
    train = allFiles[0:th]
    test  = allFiles[th:]
    X_train, y_train = make_sample(train)
    X_test, y_test = make_sample(test)
    xy = (X_train, X_test, y_train, y_test)

    np.save("irasuto_data.npy", xy)
今回、猫:0、犬:1として[画像,識別データ]でallFilesにリスト追加しております。
作成したリストに対してランダムに並び変えた後、テストデータと訓練用データに分けます。
このmake_sampleにて訓練データやテストデータに対して、
説明変数X:画像、目的変数Y:識別データ(犬 or 猫)
の登録を行います。
ソースはこんな感じ。
def make_sample(files):
    global X, Y
    X = []
    Y = []
    for cat, fname in files:
        add_sample(cat, fname)
        add_rotate_sample(cat, fname, 45)
        add_rotate_sample(cat, fname, 90)
        add_rotate_sample(cat, fname, 135)
        add_rotate_sample(cat, fname, 180)
        add_rotate_sample(cat, fname, 270)
    return np.array(X), np.array(Y)

def add_sample(cat, fname):
    img = Image.open(fname)
    img = img.convert("RGB")
    img = img.resize((150, 150))
    data = np.asarray(img)
    X.append(data)
    Y.append(cat)

def add_rotate_sample(cat, fname, rotates):
    img = Image.open(fname)
    img = img.convert("RGB")
    img = img.resize((150, 150))
    img = img.rotate(rotates)
    data = np.asarray(img)
    X.append(data)
    Y.append(cat)
ここで、60枚程度では流石に足りなかったので、もともと保存していた画像を45°~270°に回転させて、データを増やしました。
5パターン追加したため、360枚のデータが登録できました。
最後に、
np.save("irasuto_data.npy", xy)で分類したデータ群を保存します。
※保存しておくと、あとで使いまわすことができるため便利。
■モデル学習
先ほどコンパイルしたモデルに対して、事前準備したデータで学習していきます。
学習する場合にはこちらの通り、model.fitにより行えます。
model = model.fit(X_train,
                  Y_train,
                  epochs=10,
                  batch_size=6,
                  validation_data=(X_test,Y_test))
モデル学習全体のコードはこちら。
# テストデータ、訓練データ用意
X_train, X_test, Y_train, Y_test = MakeTrainData()

#モデル準備
model = Compile()

model = model.fit(X_train,
                  Y_train,
                  epochs=10,
                  batch_size=6,
                  validation_data=(X_test,Y_test))
■モデル学習結果
学習結果はこんな感じになりました。
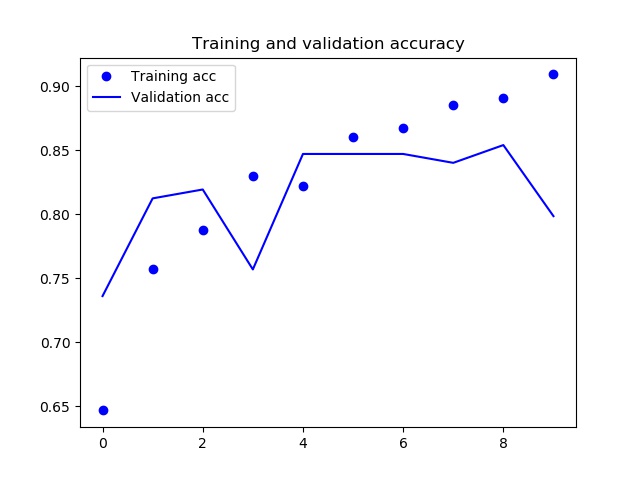
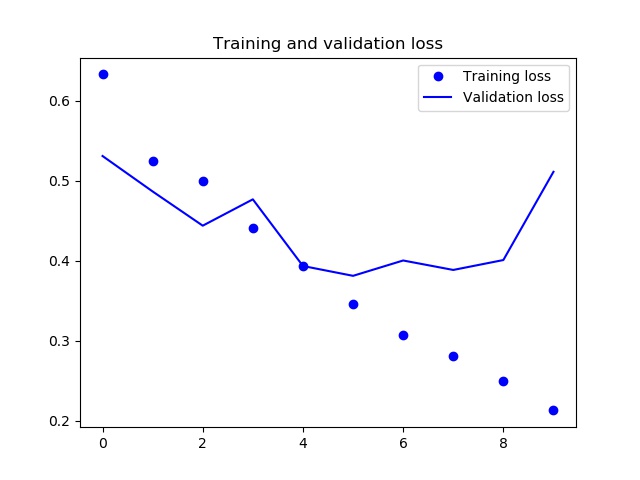
エポックが9以降でaccuracyが減少し、lossが増加傾向にあるため、過学習起こしているようです。
もう少しデータ増やした方がいいかな??
もしくはエポックを減らすか。
どちらにせよ何か手を打たなければならないかな😅
結果格納のために使用したコードはこちらです。
def ShowGraph(model):
    acc = model.history['acc']
    val_acc = model.history['val_acc']
    loss = model.history['loss']
    val_loss = model.history['val_loss']

    epochs = range(len(acc))

    plt.plot(epochs, acc, 'bo', label='Training acc')
    plt.plot(epochs, val_acc, 'b', label='Validation acc')
    plt.title('Training and validation accuracy')
    plt.legend()
    plt.savefig('accuracy.jpg')

    plt.figure()

    plt.plot(epochs, loss, 'bo', label='Training loss')
    plt.plot(epochs, val_loss, 'b', label='Validation loss')
    plt.title('Training and validation loss')
    plt.legend()
    plt.savefig('loss.jpg')
■実際に犬・猫判定してみた
ちょっと学習が不十分ですが、、、
せっかくなので、犬・猫判定してみました!!
とその前に!!
学習させたモデルを保存しておき、使いたい時に使えるようにしたいと思います。
保存のためのコードはこちらになります。
json_string = model.model.to_json()
open('irasutoya_predict.json', 'w').write(json_string)

hdf5_file = "irasutoya_predict.hdf5"
model.model.save_weights(hdf5_file)
どうやらモデルと重み付けは別ファイルで保存する必要があるようです。
判定用のコードはこんな感じ。
model = model_from_json(open('irasutoya_predict.json').read())
model.load_weights('irasutoya_predict.hdf5')

img_path = str("test/pet_ha_clean_neko.png")
img = image.load_img(img_path,target_size=(150, 150, 3))
x = image.img_to_array(img)
x = np.expand_dims(x, axis=0)

features = model.predict(x)

if features[0,0] == 1:
    print("猫です")
else:
    print("犬です")
先ほど保存した学習済みモデルを読み出し、
予測したい画像を読み出し、
評価して、結果を確認する。
以上です!!
実際にはこんな感じで判定できました。
「猫」と判定しOK。
「犬」と判定しOK。
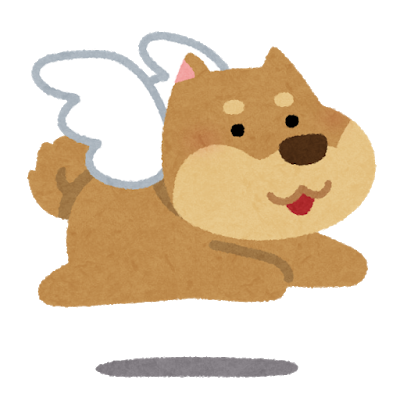
「猫」と判定しNG。
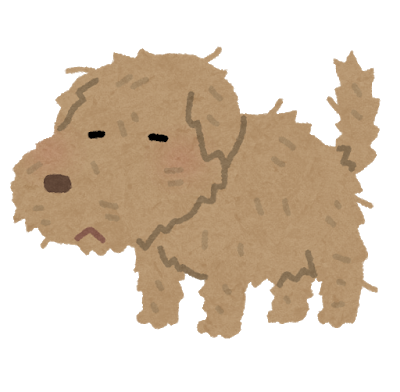
やはり、ちょっと安定してない気がしますね😅
■最後に
画像に対しても識別する方法を学ぶことができました!!
ただ、モデルの部分は他の人のを完全流用。。。
機械学習にとって一番重要な部分を他力本願にしてしまったので、これからモデルの作り方についても学んでいきたいと思います!!
以前から欲しいと思っていたこちらの本が届きましたので、読んで勉強しよっと😆
 | ゼロから作るDeep Learning ?Pythonで学ぶディープラーニングの理論と実装 新品価格 |

